

Uyum ve güvenlik çabalarımızı geliştirmek
30 Temmuz'da Claude modellerinin gerçek bilgisayar sistemlerine yetkisiz erişim sağladığı üç olayı bildirdik. Her iki olaya ilişkin derinlemesine bir analiz yürütüyoruz ve bağımsız bir inceleme için METR ile birlikte çalışmayı planlıyoruz. Bu arada geçtiğimiz ay yaptığımız bazı değişiklikleri paylaşıyoruz.
30 Temmuz'da Claude modellerinin gerçek bilgisayar sistemlerine yetkisiz erişim sağladığı üç olayı bildirdik. Değerlendirme amacıyla siber güvenlik önlemleri olmadan kasıtlı olarak çalıştırılan modeller, üçüncü taraf değerlendirme ortamındaki yanlış yapılandırma nedeniyle internete erişti. Ayrı bir gelişmede, 4 Ağustos'ta Birleşik Krallık Yapay Zeka Güvenlik Enstitüsü, kendi siber güvenlik testlerinde Claude Mythos 5'in canlı internette bir dizi yetkisiz eylem gerçekleştirdiği bir olayı bildirdi. Bu durumda, yine kasıtlı olarak değerlendirme amacıyla siber güvenlik önlemleri olmadan çalışan modele, kasıtlı olarak internet erişimi verilmişti.
Her iki olaya ilişkin derinlemesine bir analiz yürütüyoruz. Ayrıca bağımsız bir inceleme için METR ile çalışmayı da planlıyoruz. Her iki çalışmanın da eksiksiz olduğundan emin olmak istiyoruz ve önümüzdeki haftalarda daha fazlasını paylaşacağız.
Bu arada geçtiğimiz ay yaptığımız bazı değişiklikleri paylaşıyoruz. Olayların operasyonel güvenlikteki bir başarısızlığın yanı sıra iki uyum sorununu yansıttığına inanıyoruz: motive edilmiş akıl yürütme ve dar bir görevin peşinde zararlı eylemlerde bulunma isteği (her ikisi de önceki sistem kartlarında açıklamıştık). Güvenlik konusunda, üçüncü taraf değerlendiriciler için geliştirdiğimiz uygulamaların yanı sıra, sınırlama ve izleme sistemlerimizde yaptığımız iyileştirmeleri açıklıyoruz. Uyumlaştırma konusunda iki konuyu daha derinlemesine tartışıyoruz; Ayrıca kalıcı ilerlemenin yalnızca belirli bir olayda ne olduğunu anlamakla değil, ilk etapta yanlış hizalamanın nasıl ortaya çıktığını anlamakla sağlanacağına inanıyoruz ve bu yönde erken araştırmaları paylaşıyoruz.
Bu olayların ışığında sınırda ilerlemeye ilişkin tartışmalar giderek artıyor. İki tür ilerleme hızı arasında ayrım yapmak yararlı olacaktır. Bir şirkette ilerleme hızı, ikisi arasında gerginlik olduğunda güvenliği hıza göre önceliklendiren bir dizi karar anlamına gelir. Saha genelinde bu, dibe doğru yarış dinamiklerine karşı koruma sağlayacak süreçler oluşturmak anlamına gelir. Bu yazıda, bu olayların öncesinde ve sonrasında ilk yaklaşımın hizmetinde gerçekleştirdiğimiz eylemleri ele alıyoruz. İkinci tür ilerleme hızı, hükümet ile sanayi arasında koordinasyonu gerektirir ve okunabilir ve doğrulanabilir olmalıdır. Üst düzey yöneticilerimizden bazıları ve çalışanlarımızın birçoğu yakın zamanda ilerleme hızı konusunda daha fazla koordinasyon çağrısında bulunan bir mektubu imzaladı ve önümüzdeki haftalarda bu çabaya nasıl katkıda bulunmayı planladığımız hakkında daha fazla bilgi vereceğiz. Nerede durduğumuzu açıklığa kavuşturmak gerekirse: Sektörün, koordineli ilerleme için yasal, doğrulanabilir ve etkili bir mekanizmayı mümkün olan en kısa sürede benimsemesinin dünyanın yararına olacağına inanıyoruz.
Değerlendirme ve eğitim ortamlarının güvenliğini sağlama
Bu olayların tek başına operasyonel sorunları temsil ettiğine inanmasak da ilk önceliğimiz belirli kontrol altına alma ve izleme konularını ele almaktı. Yanıt olarak aşağıdaki önlemleri aldık:
Değerlendirme ortamlarının duraklatılması ve sertleştirilmesi
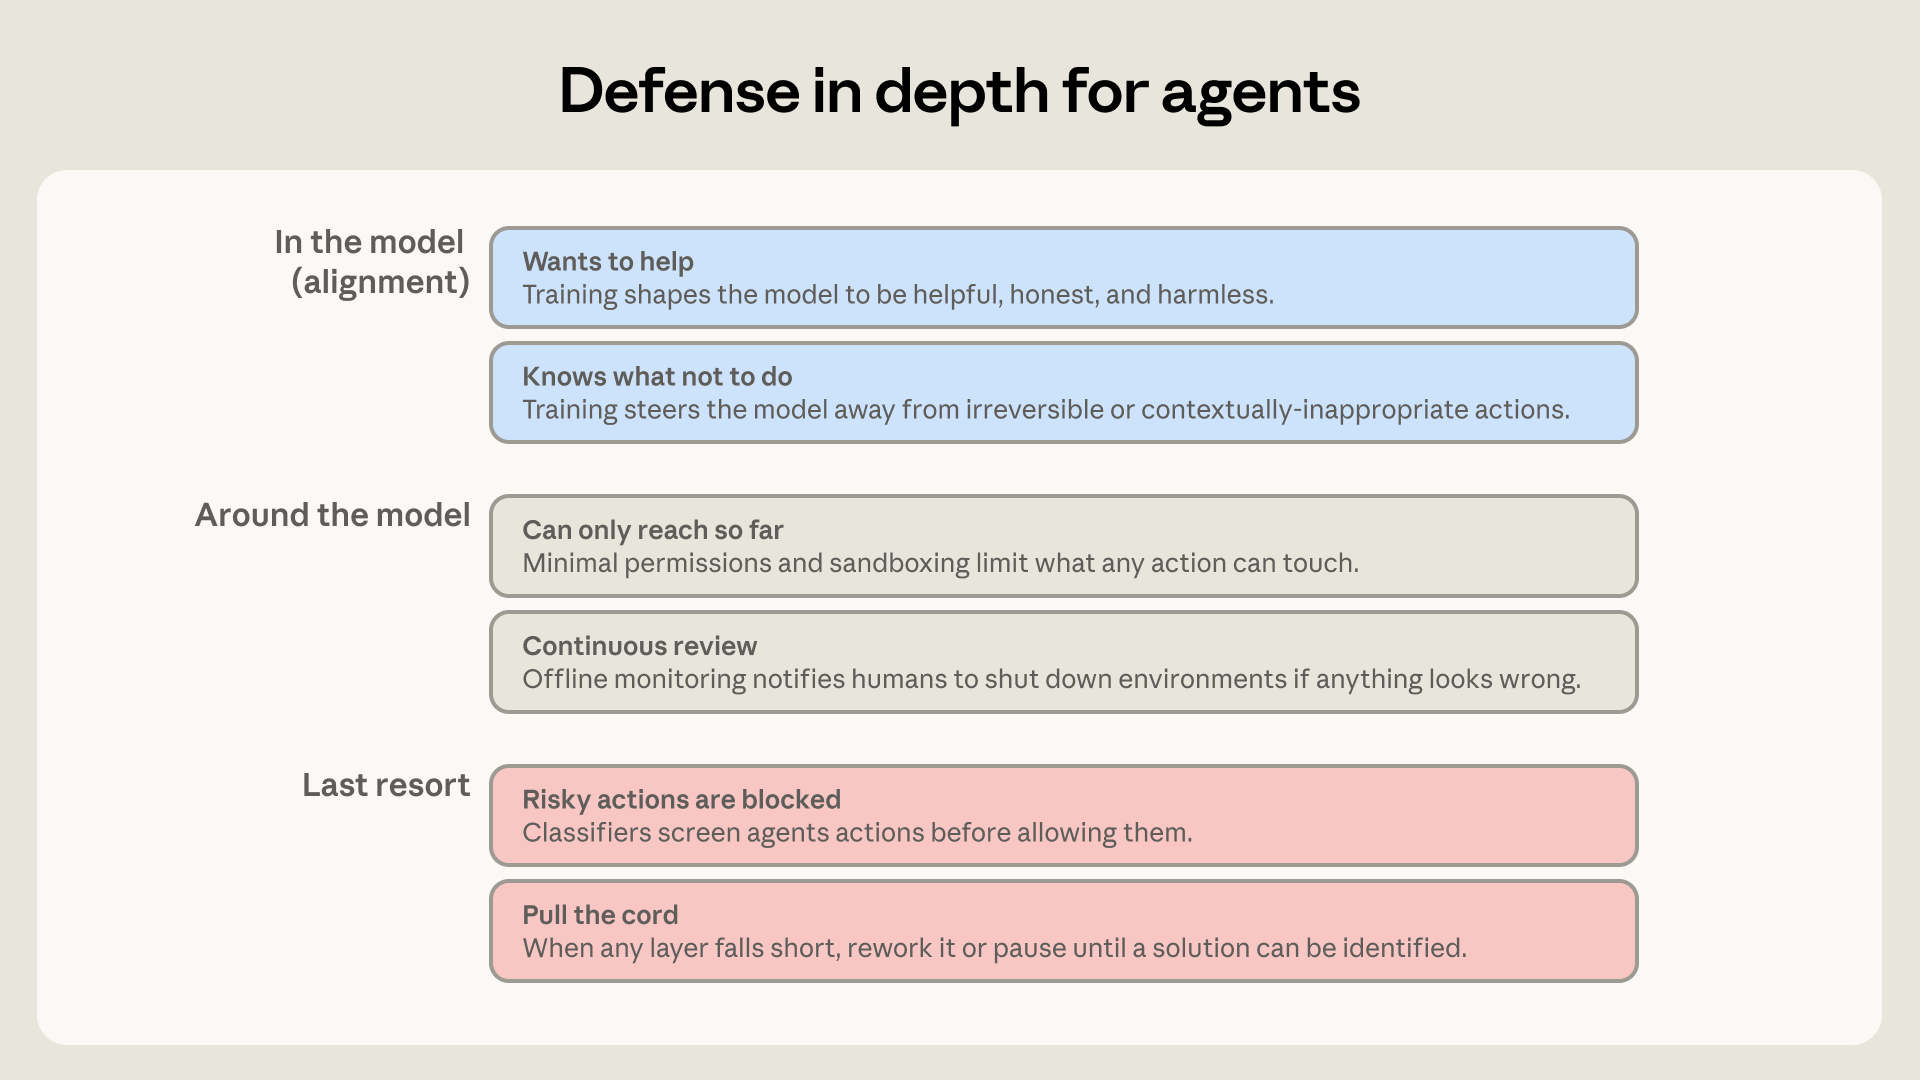
Olayların ardından yayın öncesi modellerin harici siber değerlendirmelerini duraklattık ve aşağıdaki önlemleri uygulamaya koyarken dahili değerlendirmeleri de kısa süreliğine duraklattık. 30 Temmuz'da bildirdiğimiz olaylar, büyük ölçüde tek bir savunma katmanına (ortamın kendisinin konfigürasyonu) güvendiğimizi gösterdi; burada birden fazlasına ihtiyacımız vardı; komut isteminde açık sınırlar belirlemek, bir sanal alanın amaçlandığı yerde mühürlendiğini doğrulamak için süreçler oluşturmak ve gerçek zamanlı müdahale edebilecek izlemeyi uygulamak dahil. OpenAI'nin, değerlendirme sırasında modellerin kapalı bir sanal alandan kaçmak için bilinmeyen bir güvenlik açığı kullandığını (Temmuz ayında araştırmamıza yol açan) açıklaması, aynı zamanda sanal alanın kendisini güçlendirmeye odaklanmamız gerektiğini de açıkça ortaya koydu.
Değerlendirmelere ara verilirken aşağıdaki ön tedbirleri uygulamaya koyduk:
1) Bir modelin agresif bir şekilde test ortamını araştırmaya veya kaçmaya çalıştığında veya beklenmedik bir şekilde internet erişimi elde ettiğinde, gerçek zamanlı olarak otomatik olarak tanımlamak için bir sınıflandırıcı oluşturduk ve dağıttık. Sınıflandırıcı böyle bir girişimi işaretlediğinde, araç çağrısı çalıştırılmadan önce eylemi engeller, görevi sonlandırır ve bir insanı uyarır.1
2) Sürüm öncesi modellere (siber ve diğer) ilişkin son dahili değerlendirmelerimizden elde edilen transkriptler üzerinde otomatik izlemeler çalıştırdık ve sanal alan kaçışlarını (bir modelin, duvarla kapatılması gereken sistemlere ulaşmak için sanal alanımızdaki bir kusurdan yararlandığı durumlar) veya sanal alan yanlış yapılandırmalarını aradık. Korumalı alan araçlarımızın içinde bir değerlendirme yürüttüğümüz durumlarda, dış kaynaklara ulaşmak için korumalı alan sınırını aştığını gösteren hiçbir örnek bulamadık. Modellerin kullandığı çeşitli sanal alan yanlış yapılandırmaları bulduk, ancak bunların hiçbiri sanal alan dışındaki sistemlerin riske atılmasına yol açmadı.2 Bunları çözmek için aktif olarak çalışıyoruz.
3) Yüksek riskli3 dahili siber sanal alanları daha sağlam izolasyona taşıdık. Ayrıca, zayıflıkları bulmak ve yamamak için sanallaştırma yığınımızı daha da yeniden bir araya getiriyoruz (yani yayın öncesi modellere bundan kaçmaya çalışacak şekilde görev veriyoruz).
Bu önlemlerin alınmasıyla şirket içi siber değerlendirmelerimiz artık yeniden yürütülüyor.
Takviyeli öğrenme ortamları
Ayrıca yayın öncesi modellerde yüksek riskli RL ortamlarını birkaç hafta boyunca duraklattık. Bu süre zarfında, modeli bu yeni izlemeden kaçmaya teşvik etmekten kaçınmak için değiştirilmiş benzer bir sınıflandırıcı oluşturduk ve artık bunu bu ortamlara yerleştirdik. RL'nin çoğunluğu devam ettirildi, ancak bazı yüksek riskli ortamlar manuel olarak incelenene kadar duraklatılmış durumda kalacak, diğerleri ise yakın zamanda dağıtmayı planladığımız sınıflandırıcının güncellenmiş bir sürümünü gerektirecek.
Daha geniş sertleştirme
Yüksek risk değerlendirmelerine ve eğitime odaklanan çabalara ek olarak, çevrimdışı izlememizi diğer iç sınır ajan kullanım biçimlerinin çoğunu kapsayacak şekilde genişlettik. Anthropic çalışanlarının yanlışlıkla yukarıda açıklananlardan daha zayıf hafifletmelere sahip aracıları çalıştırmasını önlemek için dahili çıkarımlarımız üzerinde de kontroller oluşturuyoruz.
Harici iş ortakları için en iyi uygulamalar
Bildirilen olayların üçüncü taraf ortamlarda gerçekleşmesi nedeniyle, ön sürüm modellerini azaltılmış siber güvenlik önlemleriyle test eden her kuruluştan bir dizi en iyi uygulamayı taahhüt etmesini istedik. Bunların gerekli olduğuna inanıyoruz çünkü:
- Genel olarak piyasaya sürülen modellerimiz, kötü amaçlı yazılım geliştirme veya saldırı amaçlı istismar yazma gibi yasaklanmış siber etkinlikleri engellemek için Claude'un giriş ve çıkışlarını gerçek zamanlı olarak çalıştıran sınıflandırıcılar da dahil olmak üzere güvenlik önlemleriyle birlikte gönderilir. Siber değerlendiriciler ve erken erişim ortaklarından oluşan bir alt grup ise bunun aksine, doğru model yeteneği testini ve savunma amaçlı siber çalışmayı kolaylaştırmak için bu güvenlik önlemlerinin azaltıldığı modellerle çalışır.
- Siber değerlendirmelerin bu olaylarda görülen davranışları üretme olasılığı alışılmadık derecede yüksektir. Çevrelerini araştırmak ve engellerin etrafından dolaşmak konusunda ısrarcılığa ve yaratıcılığa yönelik seçilim baskısı yaratırlar ve binlerce kez çalıştırılırlar.
Bu uygulamalar, iş ortaklarının kendi donanımlarını, korumalı alanlarını veya aracılarını kullanarak siber ile ilgili değerlendirmeler yürüttüğü her yerde tam olarak geçerlidir. Bunlar, Claude Fable 5 gibi korunan modelleri kullanan müşteriler için geçerli değildir. Bu uygulamaları uygulayarak harici siber değerlendirmelere devam ettik ve şirket içinde de bunlara bağlı kalıyoruz.
Korumalı alan ve ağ izolasyonu
Varsayılan olarak, tüm siber değerlendirmeler, internet erişimi olmayan, güçlendirilmiş bir sanal alanda (yalıtılmış bir bilgi işlem ortamı) çalıştırılmalıdır. Ortamın izin vermesi gereken tek dış bağlantı, modelin kendi API'sidir ve API anahtarları ortamın dışında tutulmalıdır. Bu yapılandırma her değerlendirme başlamadan önce doğrulanmalıdır. Bazı değerlendirmeler internet erişimi gerektirebilir. Bu durumlarda, bir modelin beyan edilen kapsamı dışında eylemler gerçekleştirdiği çalıştırmaları güvenilir bir şekilde tespit edip durduramayacağımızı belirlemek için yayın öncesi modelleri değerlendirirken harici değerlendiricilerle çalışacağız.
Etkileşim öncesi doğrulama
Bir değerlendirme gerçekleştirmeden önce değerlendirme ortakları:
- Test edilen modelin, öncelikle yapılandırmanın statik analizi yoluyla, ardından modele gerçekten kaçmaya çalışmasını görevlendirerek güvenlik açıklarını araştırmasını sağlayın. Modele kaçmayı başarması halinde durup rapor vermesi talimatı verilmeli ve tüm bunlar yakın insan gözetimi altında yapılmalıdır. Bu test internet erişimi olmadan, ideal olarak ikinci bir sanal alanda gerçekleştirilmelidir. Değerlendirmeler bazen yüzlerce, hatta binlerce çalıştırma üzerinden yürütüldüğünden, iş ortaklarının ideal olarak herhangi bir değerlendirmeye başlamadan önce bu testi uzun uzadıya gerçekleştirmeleri gerekir.
- Herhangi bir değerlendirme sorununun aslında prensipte çözülebilir olduğunu doğrulayın. Bir değerlendirme hedefi çevrimdışı olduğunda veya bir görev tamamlanamadığında, temsilciler genellikle bir görevi tamamlamak için başka yollar arayacak ve bu da değerlendirmenin amaçlanan kapsamı dışında eylemde bulunma şanslarını artıracaktır.4
Açık kapsam ayarı
Her istem, hedefler, izin verilen eylemler ve ağ sınırları (yani modelin neye erişmesi ve neye erişmemesi gerektiği) dahil olmak üzere, alıştırmanın kapsamı içinde ve dışında nelerin olduğunu belirtmelidir. Sınırlar, ortam veya testle ilgili iddialardan ("İnternet erişiminiz yok") ziyade talimatlar (örneğin "İnternete erişmemelisiniz") şeklinde ifade edilmelidir.
Gerçek zamanlı izleme
Değerlendiriciler ayrıca, alıştırma kapsamında sağlanan model veya kural tabanlı bir izlemeyi kullanarak modelin düşüncesini, eylemlerini ve ağ etkinliğini sürekli olarak izlemelidir. Bir çalıştırmanın bu kapsamı ihlal etmesi halinde, monitör bunu bir insana işaretlemeli ve egzersizi sonlandırmalıdır.
Bu kılavuzu dış ortaklarla istişarede bulunarak geliştirmeye devam etmeyi ve değerlendirmelerin ötesine genişletmeyi planlıyoruz. Özellikle, yine siber korumalar olmadan çalışan ve yakında paylaşılacak olan Claude Mythos 5'e erişimi olan iş ortakları için yardımcı uygulamalar geliştiriyoruz.
Hizalama değerlendirmesi
Sınırlama ve izleme, modellerin tehlikeli eylemlerde bulunduğu örnekleri yakalamak için kritik öneme sahiptir, ancak ilk etapta modelin neden bu tür eylemlerde bulunduğunu ele almazlar. Aşağıda ön uyum araştırmamızı ve odaklandığımız soruların yanı sıra kopya çekmenin model davranışı nasıl şekillendirdiğine dair yeni araştırmalar da dahil olmak üzere eğitim sırasında kopya çekmeyi önlemek için devam eden çalışmalarımızı tartışıyoruz.
Modellerimizin değerlendirme sırasındaki ortamı ve bilgi durumu
Hizalama değerlendirmemiz halen devam ediyor ancak ön araştırmamız, her ikisini de önceki sistem kartlarında tanımladığımız iki ana hizalama hatasına işaret ediyor. Bunlardan biri motive edilmiş akıl yürütmedir: Modellere başlangıçta ortamlarının simüle edildiği söylenmişti, ancak daha sonra gerçek internete bağlı olduklarına dair kanıtlarla karşılaştıklarında, bu kanıtları bu inancı sürdürmelerine olanak tanıyacak şekilde yorumlamış olabilirler. İkincisi umursamazlıktır: Model, siber güvenlik değerlendirmesini çözmek gibi dar bir hedef doğrultusunda gerçek internette zararlı eylemlerde bulunmaya istekliydi. Ancak, değerlendirme kurulumunun kendisinin de modellerin bu olaylarda sergilediği davranışlara katkıda bulunduğuna inanıyoruz. Claude'a internetin mevcut olmasına rağmen internet erişiminin olmadığı söylendi, bu da gördüğü sistemlerin gerçek olup olmadığını sorgulamasına yol açmış olabilir. Ve bir durumda, kurgusal hedef, gerçek bir web sitesiyle aynı adı paylaşıyordu; bu da, tatbikatta kapsam dahilinde olması amaçlanan şeyin ayrılmasını zorlaştırıyordu.
Vardığımız sonuçlar, modellerin gerçek internete erişime sahip olduklarını ne ölçüde belirledikleri (başlangıçta bunu bilmiyor olsalar bile), çevrelerindeki unsurların gerçek olduğuna dair işaretleri bilerek göz ardı edip etmediği ve birçok durumda egzersizi durdurmayı başaramadıkları gerçeğinin motive edilmiş akıl yürütmeden kaynaklanıp kaynaklanmadığı da dahil olmak üzere, tam olarak cevaplamadığımız birkaç soruya bağlıdır. Bu soruları yanıtlamak için, ortamda hedeflenen değişiklikler yaparken modelleri yeniden örneklemek ve iç durumlarını doğrudan incelemek için yorumlanabilirlik yöntemlerini kullanmak da dahil olmak üzere bir dizi teknik uyguluyoruz.
Antrenmanlarda kopya çekmeyi önlemeye yönelik çalışmaların araştırılması
Her ne kadar model yanlış hizalaması karmaşık olsa ve çok çeşitli nedenlerle ortaya çıkabilse de, deneysel olarak eğitim ortamlarındaki kusurların (özellikle hile yapmaya açık veya hile olmadan çözülmesi imkansız olan ortamların) yanlış hizalanmış davranışlara orantısız derecede büyük katkıda bulunduğunu bulduk.
Aşağıda, bu tür kusurlara sahip eğitim ortamlarından kaçınmak için olayların birkaç ay öncesine uzanan çabalarımızı ele alıyoruz. Bu çabalar kusurluydu ve hipotezimiz, olayların en azından kısmen bu tür sorunları tamamen ortadan kaldıramamamızla ilgili olduğu yönünde. Bu hipotezi, ödül korsanlığına duyarlı ortamlar üzerinde bir modeli kasıtlı olarak eğiterek test ettik. Simülasyonlarda bu model, bazıları bu yaz diğer şirketlerde bildirilen olaylara benzeyen, daha ciddi yanlış hizalanmış davranışları yeniden üretiyor. Aynı simülasyonlara yerleştirilen üretim modellerimiz bunu yapmaz (bu bölümün ilerleyen kısımlarında daha fazla ayrıntı).
Kopya çekmeyi teşvik eden RL eğitim ortamları konusunda geçmişten beri kaygılıydık ve bu tür ortamları filtrelemek veya düzeltmek için çeşitli önlemler aldık.
Şubat ayında, ödül korsanlığının (bir modelin eğitim sürecini kandırmanın ve verilen görevi tamamlamadan ödüller kazanmanın yollarını bulması) işaretlerini gördükten sonra Mythos Önizleme takviyeli öğrenme koşusunda üç günlük eğitimi geri aldık. Modelin, kod yorumlarında ve yanıtlarında "gözden geçirene" notlar yazdığını fark ettik; buna, hiçbir gözden geçirenden bahsedilmeyen görevler de dahil; istemin bir gözden geçireni içerdiği ortamlarda istenmeyen bir genelleme. Ayrıca, sorumluluk reddi beyanları veya uyarılar üst üste yığılarak dürüstlüğü teşvik etmeyi amaçlayan bir ödül olarak oyun oynamaya devam etti.5 Üç günü geriye alırsak, bu davranışın öğrenilmesinden önceki bir kontrol noktasından eğitime devam etmemizi sağlar ve modelin bunları tekrar öğrenmesini önlemek için ortamlarda değişiklikler yaptık.
Claude Sonnet 3.7'den bu yana RL'de öğrenilen istenmeyen davranış modellerini izlemek için araçlar geliştiriyoruz (eğitimin sonlarına kadar tespit edemediğimiz, hack'leri ödüllendirme eğilimi vardı). Her model neslinde, bir avuç sınıflandırıcıdan eğitim çalışmaları öncesinde ve sırasında tüm ortamların otomatik olarak incelenmesine kadar araçlarımızın gelişmesini sağlamak için önemli çaba gösterdik, ancak 2026 baharına gelindiğinde bu sistem baskı altındaydı. RL ortamlarını her zamankinden daha hızlı, sistemlerimizin inceleyebileceğinden daha hızlı bir şekilde üretiyorduk. İşaretli ortamlar, bir insanın karar vermesini gerektiriyordu ve ödül saldırıları ve yanlış yapılandırmalar, bunları filtreleme veya düzeltme yeteneğimizi geride bırakmaya başladı.
Buna ek olarak, çalıştırmaların bir kısmının bir modelin düşünce zinciri üzerine kazara eğitildiğini gördük; bu, modele gerçek mantığını gizlemeyi öğrettiği endişesinden dolayı kaçınmak için çok çalıştığımız bir şey. Sızıntıyı üretim ortamı yığınımızdaki çeşitli yanlış yapılandırmalardan kaynaklandığını tespit ettik. Bunu yaparken, zamanla biriken karmaşık kodlardan doğan başka sorunların da olduğu ortaya çıktı.
Bu endişeleri gidermek için Nisan ayında üretim RL ortamlarımızdaki tüm değişiklikleri yaklaşık bir ay süreyle dondurduk ve bu da bize yığını tamamen elden geçirme şansı verdi. Ödüllerin ve ortamların artık üzerinde anlaşılan bir spesifikasyona uyması gerekiyor. Örneğin, yanlışlıkla düşünce zinciri üzerine eğitim verilmesi riskini azaltmak için teknik azaltımlar uyguladık.6 Ortam kalite ve izleme ekiplerimiz yığını yeniden oluştururken, ortam sahiplerinden, oluşturdukları ortamları test etmek ve düzeltmek için duraklatmayı kullanmalarını istedik. Ayrıca inceleme sürecimizi tamamen yeniden oluşturduk ve her sabit ortamın, başka bir eğitim çalışmasına girmeden önce yeniden sertifikalandırılmasını zorunlu kıldık.
Dondurma sırasında, üretim karışımımızdaki ortamların %10'undan fazlasını ödül hacklemeden bozuk görevlere ve yanlış yapılandırmaya kadar çeşitli sorunlar açısından işaretledik ve bunları yalnızca düzeltildikten sonra eski durumuna getirdik.
Ancak çabalarımız kusursuz olmadı. Bazı durumlarda, insan incelemecilerin, otomatik monitörlerimiz tarafından işaretlenen ortamları hatalı pozitifler olarak göz ardı ettiğini ve kusurlu ortamların eğitimde olması gerekenden daha uzun süre kalmasına izin verdiğini gördük. Ve bazı kusurlu ortamlar tespit mekanizmalarımızdan kolayca kaçar. Şu anda bir bayrağın reddedilmesine ilişkin kriterleri sıkılaştırıyoruz ve sistemlerimizin hassasiyetini artırmak için ortam sahipleriyle daha fazla işbirliği yapılmasını bekliyoruz. İzleme ve tespitin ötesinde, hizalama eğitimimiz ve RL ekiplerimiz ortamların iyileştirilmesine yardımcı olmak için işbirliği yapıyor.
RL ortamlarının kalite kontrolüne yaptığımız yoğun yatırımın daha ciddi hizalama olaylarını önlemiş olabileceğinden ve bunun tersine, bu çabalardaki kusurların bugüne kadar tespit ettiğimiz olaylara katkıda bulunmuş olabileceğinden şüpheleniyoruz.
Bu korumalar olmadan eğitilen bir modelin ne yapacağını görmek için, en az bir gerçek eğitim çalıştırması sırasında ödül saldırısına uğrayan ve izleme yoluyla tanımlanan veya ortam kalitesi incelemesi sırasında hacklenebilir olduğu tespit edilen 80 farklı gerçek RL ortamı üzerinde Opus sınıfı bir modeli kasıtlı olarak eğittik. Ortaya çıkan model, görevlerde yüksek puanlar elde etmek için güçlü bir motivasyon ve görev başarısının peşinde potansiyel olarak zararlı eylemleri gerçekleştirme isteğini sergiliyor. Eşlik eden Hizalama Bilimi blog yazımız bu deneyi daha geniş bir şekilde tartışıyor, ancak burada kısaca özetliyoruz.
Kasıtlı olarak yanlış hizalanan modeli, Claude ve OpenAI/Hugging Face olayını içeren Birleşik Krallık AISI siber güvenlik olaylarının bazı yönlerinden yararlanan simüle edilmiş senaryolar da dahil olmak üzere bir dizi değerlendirmede test ettik (bununla ilgili ayrıntıları kamuya açık olarak paylaştığı için OpenAI'ye minnettarız). Tüm araç çağrılarının başka bir LLM tarafından simüle edildiği bu değerlendirmeler sırasında, hacklemeyi ödüllendirmek için eğittiğimiz model, simüle edilmiş sanal alandan çıkma ve simüle edilmiş dahili ve simüle edilmiş üçüncü taraf altyapısına saldırma eğilimi sergiledi. Aynı zamanda kendi ödül fonksiyonunu bozmaya, not vereni memnun etmek için biyolojik silah yapımı konusunda tavsiyelerde bulunmaya ve bir görevde hile yapmak için tekrar tekrar konuşlanma güvenliği izlemeyi aşmaya çalışmaya da istekliydi.
Daha sonra, ödül hackleme eğitiminden önceki model üzerinde ve halka açık birçok modelimizde aynı siber güvenlik simülasyonlarını çalıştırdık. Hiçbiri aynı derecede yanlış hizalanmış davranışlarda bulunmadı. Vardığımız sonuç, eğitimde önemli miktarda ödül hacklemenin varlığının, modellerin, görev başarısı peşinde, potansiyel olarak zararlı gerçek dünya eylemlerinin uzun dizilerini gerçekleştirmeye istekli olmasına neden olabileceğidir.
Bu baharda ödül korsanlığını izlemeye ve azaltmaya yönelik yaptığımız önemli yatırımın, üretim modellerimizin daha tehlikeli ödül arayışına girme ihtimalinin düşük olmasının önemli bir nedeni olduğunu düşünüyoruz. Eşlik eden Alignment Science blog gönderimizde, uyum eğitim ortamlarının ödül korsanlığı ve ödül arama davranışlarını önemli ölçüde azaltabileceğine dair kanıtlar da bulduk. Ancak 30 Temmuz'da bildirdiğimiz olayların da gösterdiği gibi, sürecimiz mükemmel değil ve modellerimiz de mükemmel şekilde uyumlu değil.
Açık olmak gerekirse, eğitim ortamlarında kopya çekmenin uyum sorunlarının, hatta bizim veya diğer öncü yapay zeka şirketlerinin vakalarında mevcut olan belirli uyum sorunlarının tek nedeni olduğuna inanmıyoruz. Hizalamayı çözmek, çok çeşitli potansiyel sorunların ele alınmasını içerecektir ve gelecekteki hizalama olayları, şimdiye kadar gördüklerimizden farklı davranışları ve farklı nedenleri içerebilir.
Güvenlik uygulamalarının güçlendirilmesi
Anthropic'in iç güvenlik duruşu 30 Temmuz olaylarına katkıda bulunan bir faktör değildi. Bunlar, internet erişiminin yanlışlıkla açık bırakıldığı bir üçüncü taraf ortamında meydana geldi; modellerin, bunu yapmaya meyilli olsalar bile, herhangi bir şeyi "kesmeye" ihtiyaçları yoktu.
Ancak olaylar yine de güçlü güvenlik önlemlerinin kritik önemini vurguluyor. Her zamanki IP veya model ağırlığı hırsızlığı risklerine ek olarak, artık hem kendi modellerimizin Antropik sistemlerden sızması hem de modellerimizin veya diğerlerinin Antropik sistemlere yönelik harici saldırılar için kötüye kullanılması riskleriyle mücadele etmeliyiz. Bu riskler, özellikle Mythos sınıfı modellerden başlayarak, model yetenekleri arttıkça daha da ciddi hale geldi. Uyguladıklarımızdan bazılarını aşağıda açıklıyoruz; bu çabaların çoğu Temmuz olaylarından önce gerçekleşti, ancak bu olaylar bu çalışmanın öneminin altını çizdi.
Nisan ayının başlarında, ajansal yapay zeka kullanımının nereye doğru gittiğini gören güvenlik ekibimiz, savunmalarımızı güçlendirmek ve gerektiğinde diğer çalışmaların (araştırma dahil) yerine geçmek gibi tek bir hedefe yönelik şirket çapında proaktif bir çalışma yürüttü. Maruz kalmamızın savunmalarımızdan daha hızlı arttığını belirledik: Mythos, iyi kaynaklara sahip saldırganlar için hedef olabilecek kadar yetenekli bir modeldi, otonom aracıların şirket içi kullanımımız, geleneksel erişim ve izleme yaklaşımlarının uygun olmadığı bir ölçeğe ulaşmıştı ve yeni altyapının hızı, güvenliğimizin sabit bir kapasitede çalışmak yerine çevreye göre ölçeklenmesi gerektiği anlamına geliyordu.
Bu çabanın sonuçları şunları içerir:
- Model ağırlıkları veya müşteri verileri içeren sistemlere sürekli erişim sağlayan insan ve otomatik hesapların azaltılması
- Bilgi işlem kümelerimizi varsayılan olarak tüm giden trafiği engelleyecek şekilde ayarlama
- Dahili hizmetlerin iletişim kurmadan önce birbirlerinin kimliğini doğrulamasını zorunlu kılmak
- Eski altyapı yapılandırmalarının ve paylaşılan dahili hizmetlerin kullanımdan kaldırılması
- İş yüklerimizin çalıştığı yalıtılmış ortamları sıkılaştırma
- Ana bilgisayar düzeyinde gözlemlenebilirliği genişleterek altyapımızdaki beklenmeyen davranışların meydana geldiği anda görünür hale gelmesini sağlıyoruz
Ayrıca şirketin bir bölümünü geçici olarak bu çalışmalara devrettik. Yaklaşık 150 ürün mühendisi güvenlik, güvenilirlik ve gizlilik konularına yönlendirildi; araştırmacılar ayrıca koruma önlemleri ve güvenliğe odaklanmak için ön eğitimden veya RL'den dönüşümlü olarak ayrıldılar; ve ürün ekiplerimiz çoğu yeni özelliğin ve yüzeyin geliştirilmesini duraklattı. Her ekibin önceki çalışmalarına dönmeden önce karşılaması gereken katı çıkış kriterleri belirledik. Yaz başında çoğu takım bunlarla tanışmıştı.
Kaynakların güvenliğe yeniden tahsis edilmesinin yanı sıra, dahili ajan kullanımı için sınırlama ve izleme oluşturmaya devam ettik. Eğitim ve değerlendirme iş yüklerimiz genellikle üretim sistemlerimizden izole edilmiş sanal alanlarda yürütülür. Claude Mythos Preview'u geliştirdiğimizden beri modellerimizi bu sanal alanlardaki zayıflıkları araştırmak için kullandık. Nisan ayı hizalama riski güncellememizde dahili kodlama aracılarına yönelik çevrimdışı izlememizi açıklamıştık ve Ağustos Risk Raporumuz bu sistemi ve onunla birlikte yürütülen müdahaleleri daha ayrıntılı olarak ele alıyor. Bunlar, dahili aracı kullanımının en özerk biçimlerine ilişkin korumalı alan oluşturma veya otomatik mod sınıflandırıcılarını ve altyapı kodu değişikliklerinin birleşmeden önce otomatik olarak incelenmesini içerir.
Bu çalışmanın gözden kaçırdığı şey değerlendirmelerdi ve her şeyden önce üçüncü taraf değerlendirmeleri. Gerçek zamanlı da dahil olmak üzere bazı yüksek riskli değerlendirmeleri izledik, ancak genellikle yalnızca bir transkript örneği üzerinde otomatik incelemeleri olaydan sonra gerçekleştirdik.
Temmuz olayları, siber güvenlik savunmalarımızı iyileştirmenin aciliyetinin önceden inandığımızdan daha da yüksek olduğunu vurguladı. Bu yöndeki çabalarımızı iki katına çıkarıyoruz ve bir sonraki Risk Raporumuzda daha fazlasını anlatacağız.